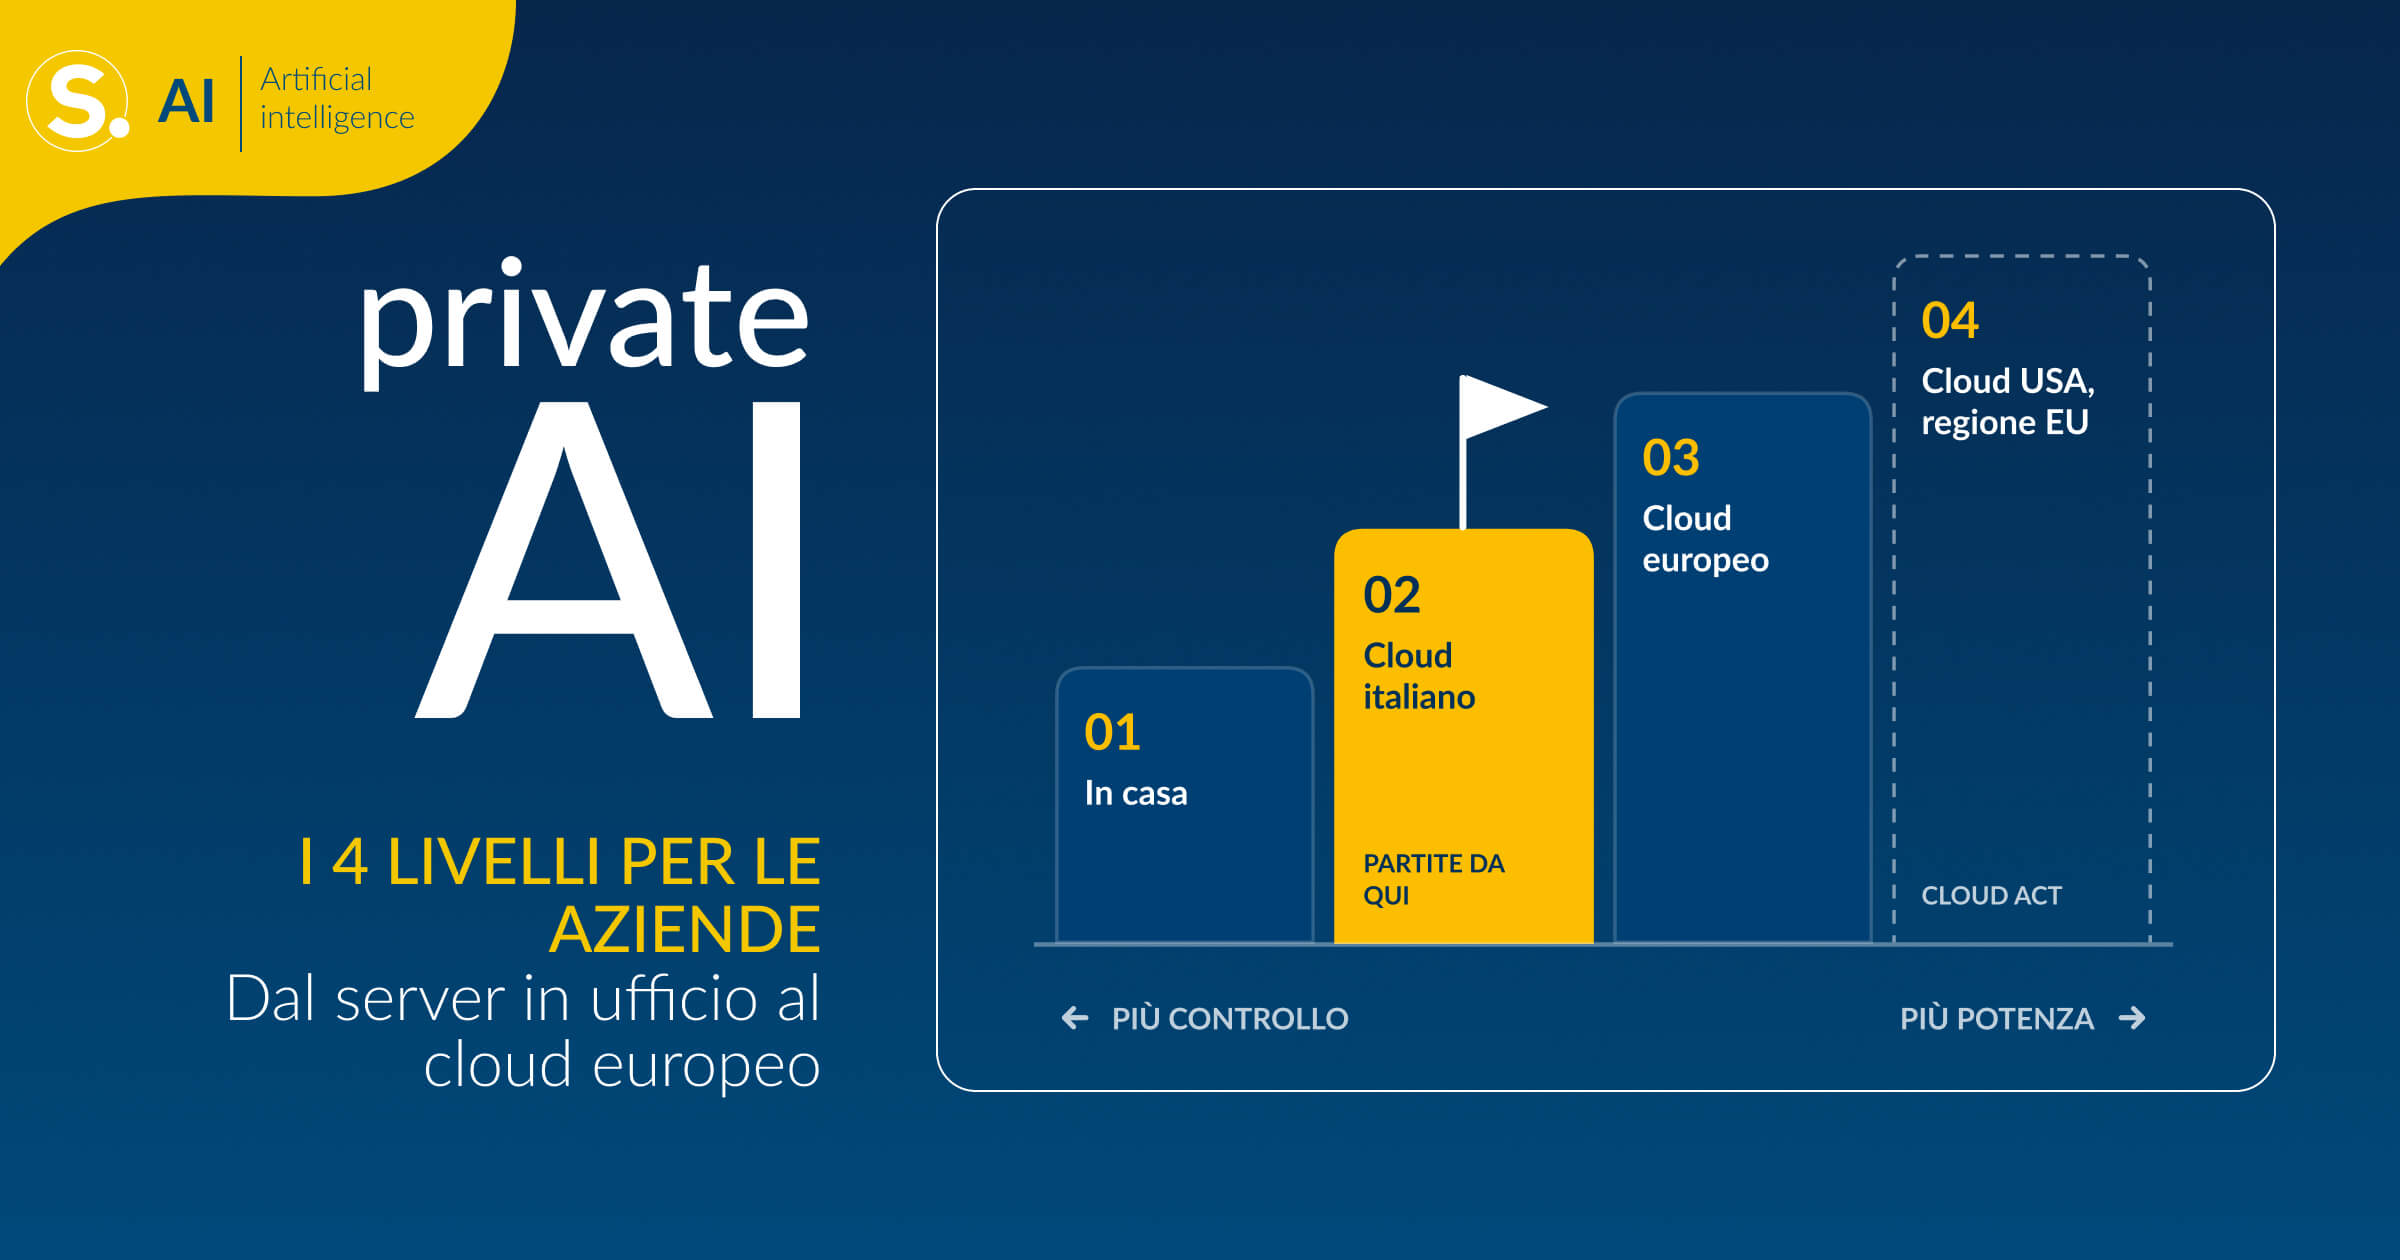
La Private AI permette alle aziende di usare l’intelligenza artificiale mantenendo il controllo su dove vengono elaborati i dati, su chi gestisce il modello e su chi ne risponde legalmente. I modelli open source oggi bastano per la maggior parte dei casi d’uso e si possono far girare a quattro livelli: in azienda, su un cloud italiano, su un cloud europeo o su un cloud americano con server in Europa. Quest’ultimo resta però soggetto al CLOUD Act e non è vera Private AI. Il consiglio è partire dal cloud italiano e combinare i livelli in base a quanto sono sensibili i dati.
Private AI significa far lavorare l’intelligenza artificiale sui dati aziendali, mantenendo il controllo su dove vengono elaborati, su chi può accedervi e sulle condizioni di utilizzo dei modelli. Oggi esistono almeno quattro livelli per realizzarla, dal device sulla scrivania al cloud europeo, con costi, competenze e garanzie legali molto diversi.
Questa guida nasce dall’esperienza di Synesthesia: da anni progettiamo e sviluppiamo soluzioni di intelligenza artificiale per aziende ed enti, e oggi la domanda che i clienti ci fanno più spesso riguarda proprio dove far elaborare i propri dati. I modelli open source hanno raggiunto una qualità adeguata per la maggior parte dei casi d’uso aziendali, e in Italia e in Europa è nato un mercato di provider che li servono su infrastrutture locali, con condizioni contrattuali pensate per rispondere alle esigenze di protezione dei dati del GDPR..
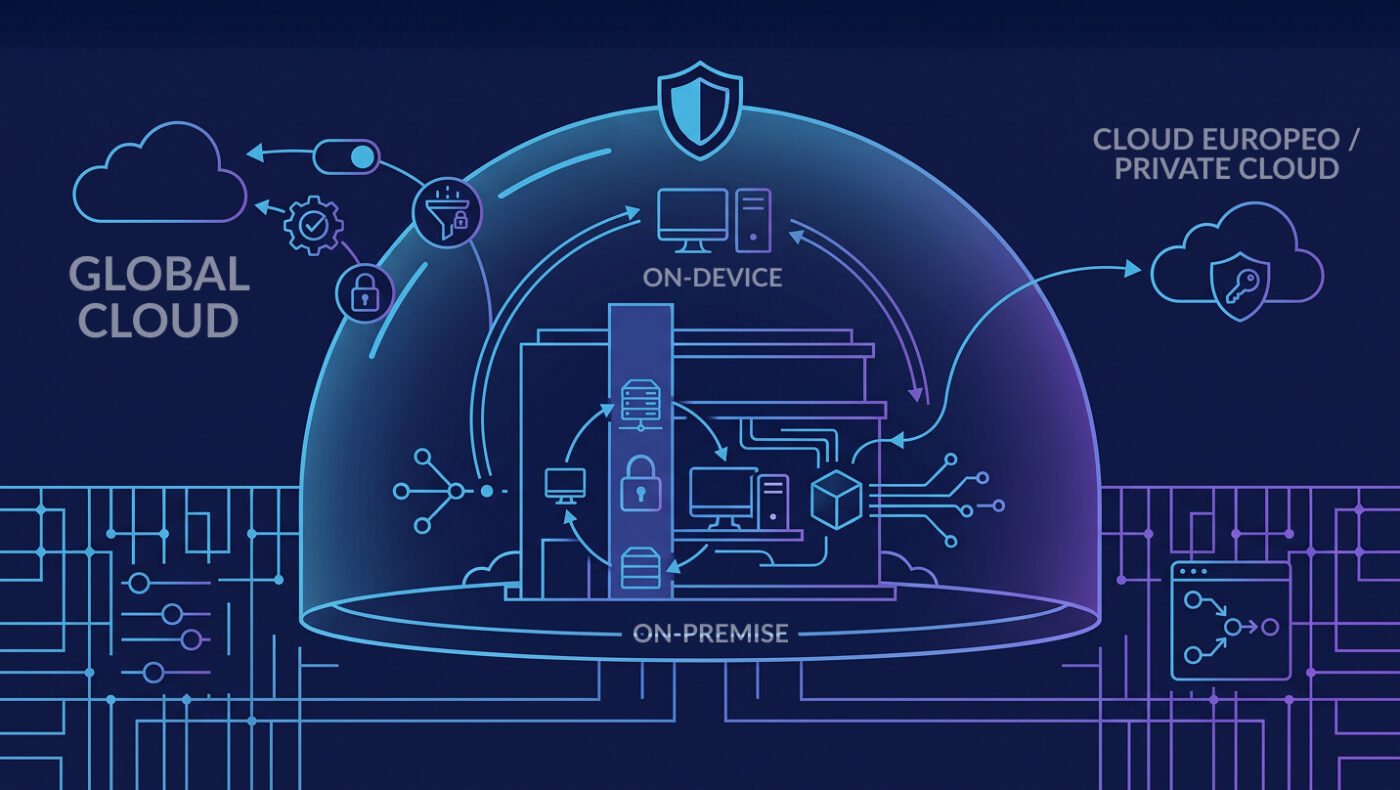
Per orientarsi, possiamo distinguere quattro livelli: dall’Ai installata in azienda ai servizi di cloud americani ospitati in regioni europee. Quest’ultima opzione è utile come termine di confronto: la residenza dei dati in Europa, da sola, non garantisce lo stesso grado di controllo delle altre configurazioni. Qui mettiamo in fila i livelli, con vantaggi e svantaggi di ciascuno, e siamo pronti ad aiutare chi vuole orientarsi in questo mondo.
Quando si affronta il tema privacy e AI prima di confrontare le infrastrutture, è utile chiarire che cosa si vuole mantenere sotto controllo.
La terza domanda è quella che di solito si salta e si approfondisce meno. È anche quella però che pesa nelle gare pubbliche, nei contratti con clienti soggetti a NIS2 e nelle valutazioni del DPO. Dal 2 agosto 2026, con gli obblighi di trasparenza dell’AI Act a regime, la risposta va messa per iscritto. Per questo va affrontata insieme alla scelta tecnica e documentata in base agli obblighi applicabili al progetto.
| In casa | Cloud italiano | Cloud europeo | Cloud USA, regione EU | |
|---|---|---|---|---|
| Chi risponde legalmente | L’azienda | Società italiana | Società europea | Controllata EU di società USA |
| Esposizione CLOUD Act | No | No | No | Sì |
| Modello portabile altrove | Sì | Sì | Sì (esclusi i Mistral proprietari) | No |
| Costo | Fisso, 4k-15k € di hardware | Per token, basso | Per token, basso | Per token, alto |
| Scalabilità | Bassa | Media | Alta | Molto alta |
| Competenze richieste | Alte | Basse | Basse | Basse |
Tutta la Private AI si regge su un presupposto: modelli scaricabili con una qualità adeguata al lavoro da svolgere.. A fine 2026, il presupposto regge su più fasce.
Tra i modelli utilizzabili su una singola macchina, con configurazioni adeguate, troviamo Qwen 3.6 27B, Gemma 4 e Mistral Small 4, tutti con licenza Apache 2.0, contesto da 256K token e input multimodale. Nella fascia alta, per esigenze più impegnative, ci sono Mistral Large 4 (circa mille miliardi di parametri, pesi pubblici dal 29 ottobre 2026), DeepSeek V4 e GLM 5: modelli da server multi GPU, ma scaricabili e ospitabili da chiunque.
La scelta va fatta su casi reali: per l’estrazione e classificazione di documenti, email e ticket, un modello da 27B può farlo con qualità indistinguibile da un modello di frontiera, cioè quelli più avanzati disponibili sul mercato.
Nei sistemi RAG, che costruiscono le risposte recuperando informazioni dai documenti aziendali, la qualità della ricerca e delle fonti può incidere quanto quella del modell. Anche il tool calling, la capacità di richiamare strumenti e funzioni esterne, degli agenti è affidabile; i flussi agentici complessi a molti passaggi e il coding autonomo su grandi repository restano il terreno dove i modelli proprietari di punta hanno un margine.
Un’avvertenza sulle licenze: Apache 2.0 (Qwen 3.5 e 3.6, Gemma 4, Mistral Small 4) non impone nulla, mentre le licenze “Community” di Llama 4 e dei Qwen 3.8 più recenti aggiungono clausole su attribuzione e soglie di utenti. Per un prodotto da rivendere, la licenza va letta prima di scegliere il modello.
Il limite va tenuto presente: un modello aperto da 27 miliardi di parametri non offre necessariamente le capacità di un modello di frontiera. Molti processi aziendali, però, possono funzionare bene anche con modelli più contenuti. Il punto è misurarlo prima di sostenere costi maggiori.
È la configurazione che offre il controllo diretto sull’infrastruttura: : il modello gira su una macchina di proprietà, dentro la rete aziendale, e nessun byte esce. Oggi una PMI ci arriva con una spesa tra 4.000 e 15.000 euro, grazie alle macchine a memoria unificata: NVIDIA DGX Spark (128 GB, stack CUDA completo, fine tuning e codice che poi gira identico in cloud) e Mac Studio (fino a 512 GB, più banda di memoria, silenzioso, il migliore per servire un modello da 70B o 120B a un team). Un server con GPU dedicate resta l’opzione più veloce, con più rumore, consumi e complessità operativa.
Vantaggi: controllo totale, nessun DPA da negoziare, costo fisso che si ripaga in pochi mesi sui carichi continui, funziona offline e in reti segregate.
Svantaggi: serve chi lo gestisce (aggiornamenti, sicurezza, backup), non scala sui picchi, l’hardware invecchia e senza ridondanza la disponibilità è quella di un PC.
Quando ha senso: dati che per legge o policy non possono uscire, carichi prevedibili, un team tecnico interno o un partner che faccia manutenzione.
In questo livello,l’hardware esce dall’azienda ma resta in Italia, da un fornitore di diritto italiano. Si rinuncia al controllo fisico diretto in cambio di scalabilità, ridondanza e zero manutenzione. Per la maggior parte delle PMI è il compromesso migliore, perchè permette di sperimentare senza acquistare hardware
L’esempio più citato è Regolo.ai, la piattaforma di inferenza di Seeweb (gruppo DHH): modelli open serviti da data center italiani con API compatibili OpenAI, quindi basta cambiare base_url e chiave. Il punto forte è la zero data retention: le richieste vengono elaborate nella memoria della GPU e liberate alla fine dello stream, con DPA standard ai sensi dell’art. 28 GDPR. Il catalogo copre Llama, Qwen, Gemma, gpt-oss e Mistral Small, più embedding, reranker, OCR e trascrizione, e c’è un’offerta white label per system integrator. Sullo stesso livello stanno le GPU dedicate o serverless di Seeweb, su cui l’azienda installa il proprio stack: più lavoro, più controllo.
Vantaggi: giurisdizione italiana al 100%, nessuna esposizione al CLOUD Act, requisiti di gara PA soddisfatti, costo per token basso, migrazione da un’API americana in poche ore, un fornitore raggiungibile con un contratto italiano.
Svantaggi: catalogo più ristretto e in ritardo di qualche settimana sui modelli nuovi, tetto di capacità più basso, nessun modello proprietario di frontiera, mercato giovane da valutare come ogni fornitore piccolo.
Quando ha senso: quasi sempre come punto di partenza per un’azienda italiana. Dati personali di clienti e dipendenti, documenti contrattuali, PA e sanità, prodotti SaaS da rivendere con garanzia di sovranità.
Allargando il perimetro all’Unione Europea si può accedere a un’offerta più ampia, mantenendo l’elaborazione su infrastrutture europee : aziende di diritto europeo, data center in UE, nessuna casa madre americana. Si perde il contratto italiano, che conta in alcune gare. Anche qui occorre verificare la struttura societaria del provider e la catena dei subfornitori, oltre al luogo in cui risiedono i dati.
| Provider | Paese | Cosa offre |
|---|---|---|
| OVHcloud AI Endpoints | Francia | Oltre 40 modelli open serverless, API compatibili OpenAI, SLA 99,5%; dal 2026 addestra una propria famiglia di modelli da rilasciare open |
| Scaleway Generative APIs | Francia | Inferenza serverless e GPU dedicate a Parigi; certificazione HDS per dati sanitari, SecNumCloud in corso |
| IONOS AI Model Hub | Germania | LLM, embedding, vector DB gestito e RAG in data center tedeschi: la piattaforma più completa per chi vuole RAG pronto |
| Nebius Token Factory | Paesi Bassi | Inferenza per modelli open e per pesi fine tuned caricati dal cliente; regione EU garantita solo sui deployment dedicati |
Il confronto va fatto sul singolo servizio: certificazioni e livelli di disponibilità possono avere perimetri diversi all’interno dell’offerta dello stesso provider.
Mistral è un caso a sé perché produce i modelli e li serve. È l’unico attore europeo che compete nella fascia alta: Mistral Large 4 ha i pesi pubblici su Hugging Face, e Mistral Studio dal novembre 2026 si installa anche in VPC o on-premise. Questo apre un’opzione unica: utilizzare un’API europea, scegliere un altro provider compatibile oppure installare il modello su un’infrastruttura controllata dall’azienda.
Vantaggi: sovranità giuridica reale con la scala di un hyperscaler medio, più modelli e servizi accessori, certificazioni settoriali (HDS, SecNumCloud, C5), accesso a un modello di fascia alta che si può portare in casa.
Svantaggi: per i requisiti “dati in Italia” non basta, il rapporto commerciale è meno diretto, Mistral è anche un potenziale concorrente di chi costruisce prodotti sui suoi modelli, e i prezzi dei suoi modelli proprietari sono allineati a quelli americani.
Quando ha senso: clienti in più paesi europei, carichi oltre la capacità di un provider italiano, bisogno di un modello di punta restando in UE.
Va detto chiaramente, perché è l’equivoco più diffuso: un modello proprietario servito da una regione europea di un cloud americano, con clausola di non addestramento, è un buon livello di riservatezza ma non è Private AI. I dati restano in Europa, e questo risolve la residenza, ma la localizzazione europea non esaurisce però la valutazione del controllo sui dati.La società che li tratta infatti risponde a una casa madre statunitense, e il CLOUD Act le consente di ricevere richieste dalle autorità americane indipendentemente da dove i dati sono conservati. Un rischio raro, che un DPO deve comunque mettere per iscritto e che in gara pesa.
A questo si aggiunge la dipendenza dal modello: pesi non scaricabili, listini decisi altrove, deprecazioni con pochi mesi di preavviso, prompt e valutazioni da rifare a ogni versione.
Vantaggi: i modelli più capaci in assoluto, ecosistema maturo, scala illimitata.
Svantaggi: giurisdizione extra UE, lock in sul modello, costo per token più alto e controllato dal fornitore.
Quando ha senso: casi che richiedono davvero la frontiera, con dati non sensibili o anonimizzati a monte. Nelle architetture ibride è lo “specialista” chiamato solo quando i livelli precedenti non bastano.
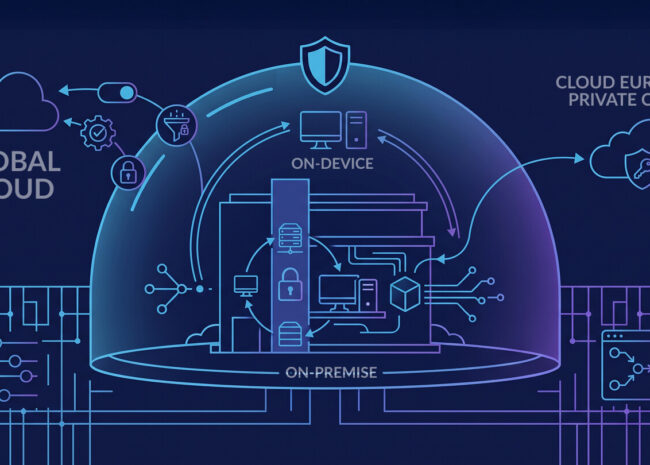
I livelli possono convivere nella stessa architettura, con un router che smista le richieste per sensibilità del dato e difficoltà del compito. Classificazione, estrazione, embedding e RAG girano in casa o sul cloud italiano con un modello da 27B: sono la maggioranza dei token e i dati più sensibili. I compiti difficili su dati già anonimizzati vanno a un modello più grande.
Un gateway unico, compatibile OpenAI, nasconde tutto alle applicazioni. Il costo scende perché l’80% delle richieste gira sul modello economico, e la compliance migliora perché escono solo dati già filtrati.
La protezione dei dati va progettata lungo tutto il percorso. Filtrare le richieste può ridurre l’esposizione delle informazioni, ma l’anonimizzazione deve essere effettiva: togliere nomi e indirizzi non basta sempre a impedire che una persona venga identificata.
Gli errori più comuni: comprare hardware prima di misurare il carico, scegliere il livello 4 “perché è il più bravo” e scoprire in gara che non è ammesso, costruire un RAG eccellente e poi mandare i chunk dei documenti riservati a un’API americana per il reranking. E dimenticare che embedding, OCR e trascrizione sono modelli anch’essi, e vanno allo stesso livello del resto.
La Private AI nel 2026 è una scala con più gradini, e ogni azienda può scegliere quello adatto a ciascun flusso di dati. I modelli open coprono ormai la grande maggioranza dei processi aziendali, e i provider italiani ed europei offrono un’infrastruttura pronta all’uso. A fare la differenza è la progettazione: decidere quale dato gira dove e costruire un’architettura che lo garantisca in automatico.
Synesthesia accompagna le PMI esattamente in questo percorso, con soluzioni di Private AI ibride e conformi a GDPR e AI Act: modelli open su infrastruttura italiana o direttamente in azienda, un router che indirizza ogni dato al livello giusto, governance e documentazione pronte per il DPO. Pesi portabili e API compatibili con gli strumenti che il vostro team usa già lasciano piena libertà di scelta anche in futuro.
Il primo passo è una mappatura dei flussi di dati di un paio d’ore con il vostro IT e il vostro DPO: un investimento minimo che chiarisce subito da dove partire. Contattateci per organizzarla insieme al team AI di Synesthesia.
Lo realizzeremo con amore e passione. Il nostro team è a tua disposizione.